Stop ai contenuti generati dai robot per difendere l’attendibilità dei dati
Immaginate di inserire il disco d’installazione di un’enciclopedia multimediale e scoprire che i testi sono stati inventati da un algoritmo che inventa i fatti. Ecco perché la comunità ha deciso di staccare la spina ai contenuti sintetici.
Difesa della verità contro i modelli linguistici
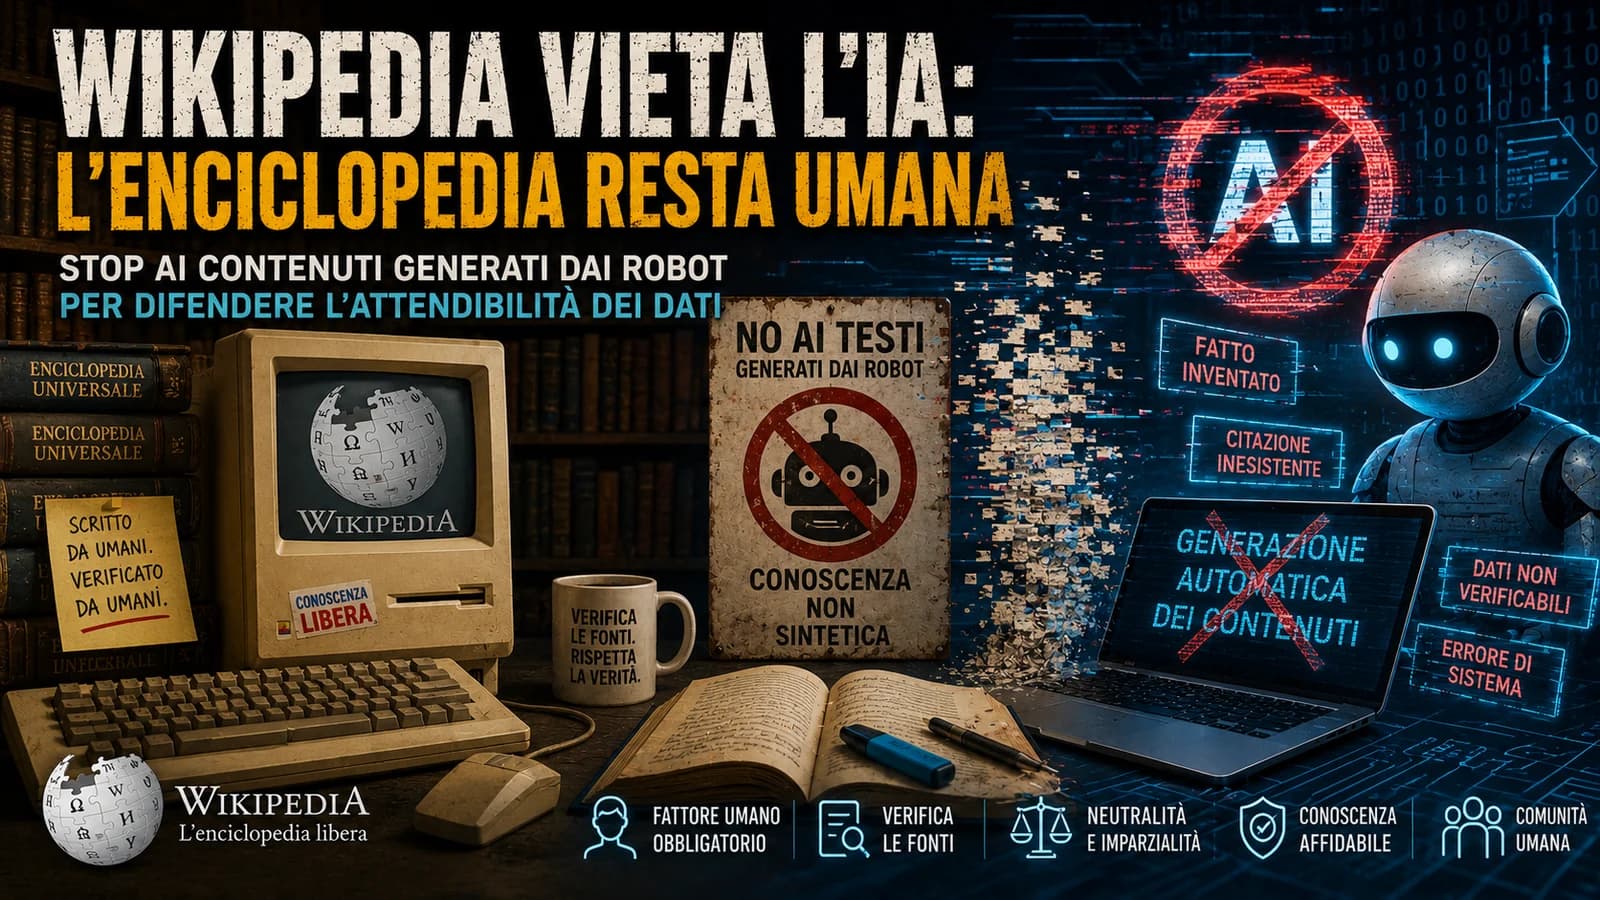
La versione in lingua inglese di Wikipedia ha dichiarato ufficialmente la fine per i testi scritti interamente dai robot. Gli amministratori hanno introdotto una regola ferrea che proibisce l’uso dell’intelligenza artificiale generativa per creare o riscrivere le voci. Al centro della disputa ci sono i modelli linguistici di grandi dimensioni (LLM), accusati di violare i pilastri fondamentali del sito. Il rischio principale riguarda la capacità di questi sistemi di generare errori di sistema logici o inventare citazioni mai esistite, minando la verificabilità e la neutralità delle informazioni. Questa scelta editoriale punta a mantenere il progetto come un porto sicuro in un web sempre più sommerso da contenuti prodotti in serie.
Il fattore umano resta obbligatorio
Nonostante il giro di vite, Wikipedia non ha attivato un protocollo di blocco totale, ma ha preferito stabilire dei confini precisi. L’uso della tecnologia resta permesso per piccoli miglioramenti stilistici oppure per le traduzioni, a patto che ci sia un revisore umano a supervisionare ogni singola parola. Un utente deve essere competente in entrambe le lingue per evitare che un errore semantico distorca il significato originale del testo. La preoccupazione maggiore è che gli algoritmi possano alterare i fatti storici o scientifici con una sicurezza tale da ingannare anche i lettori più attenti. La resistenza guidata da utenti storici come Chaotic Enby descrive questo movimento come una scelta di autonomia culturale contro l’imposizione delle aziende tecnologiche.
Una sfida tra algoritmi e revisori
La battaglia per la trasparenza non è uniforme in tutto il mondo, poiché ogni versione linguistica dell’enciclopedia gode di una propria sovranità legislativa. Se Wikipedia inglese ammette eccezioni minime, quella spagnola ha scelto una linea ancora più dura, vietando l’uso di questi strumenti senza compromessi. Il problema tecnico resta tuttavia irrisolto: non esiste ancora un programma capace di identificare con certezza assoluta se un paragrafo sia stato scritto da un uomo o da una macchina. Questo limite costringe i volontari a un lavoro di monitoraggio costante, simile a chi cerca di riparare un settore danneggiato di un vecchio disco rigido mentre i dati continuano a scorrere.
Il mio verdetto da vecchio appassionato di BBS
Leggere Wikipedia sapendo che dietro ogni virgola c’è il sudore di un essere umano mi fa sentire al sicuro, come quando riuscivo a liberare memoria convenzionale per far girare un gioco pesante. L’IA è uno strumento potente, ma l’enciclopedia deve rimanere un tempio della consapevolezza umana, non un magazzino di dati sintetici pronti al riciclo.
Cosa ne pensate di questo muro alzato da Wikipedia? Credete che gli umani riusciranno a distinguere i testi artificiali a lungo o è una battaglia persa in partenza? Scrivetelo nei commenti!
Seguite FullStackgarage.it per restare aggiornati sulle prossime rivoluzioni digitali.
Al prossimo articolo! Ci leggiamo nella prossima sessione di terminale!
Il Vostro decriptatore di nastri magnetici
Ciucci Gilberto