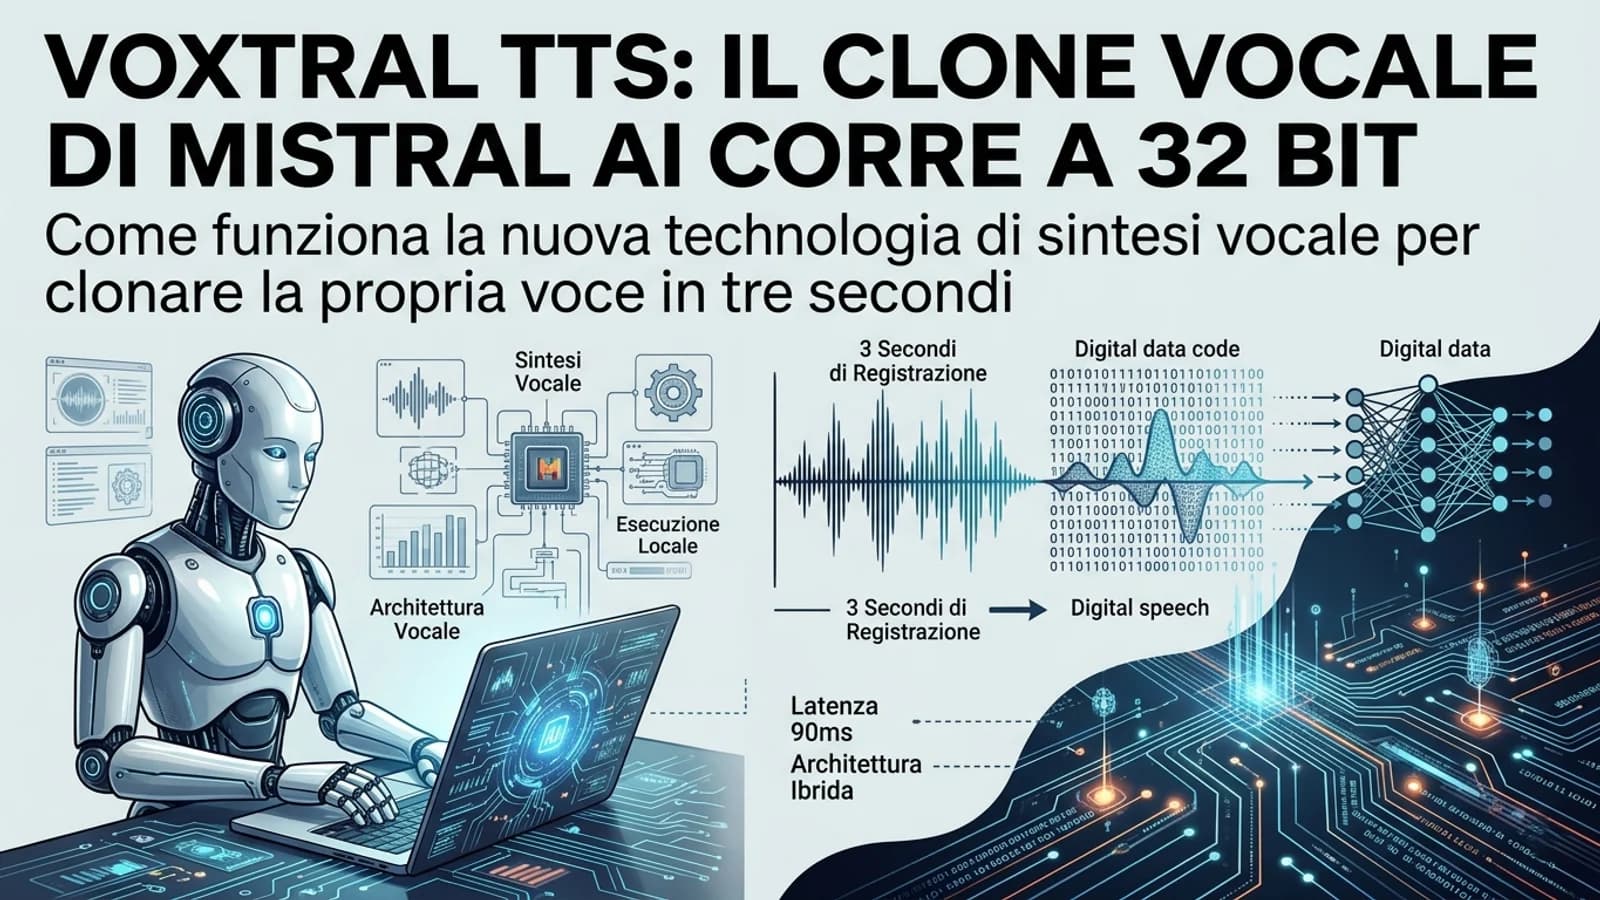
Come funziona la nuova tecnologia di sintesi vocale per clonare la propria voce in tre secondi
La nuova architettura rilasciata dal team francese su Hugging Face si presenta con una dotazione tecnica imponente da 3,4 miliardi di parametri. Per chi mastica pane e silicio, il dato più impressionante riguarda la velocità di elaborazione: il sistema richiede appena tre secondi di registrazione audio per mappare le caratteristiche uniche di un parlatore. Grazie a una latenza di soli 90 millisecondi, la risposta del software risulta quasi istantanea, superando le prestazioni di molti sistemi chiusi e a pagamento che dominano il mercato attuale.
Architettura neurale e potenza di calcolo locale
Il segreto di questa velocità risiede in una struttura ibrida che combina un trasformatore di decodifica con un codificatore neurale di ultima generazione. Questa combinazione permette di generare dieci secondi di parlato in circa un secondo e mezzo di tempo reale. Poiché il modello supporta nove lingue diverse e dimostra una grande efficienza nell’apprendimento senza esempi, la qualità della voce sintetizzata mantiene una naturalezza che ingannerebbe persino i sensori di un replicante.
Un vantaggio decisivo per gli appassionati della riservatezza è la possibilità di eseguire il codice sorgente aperto direttamente sul proprio hardware domestico. Invece di inviare campioni biometrici sensibili verso un cloud remoto e potenzialmente insicuro, gli utenti possono mantenere il controllo totale dei propri dati. Questa caratteristica posiziona Voxtral TTS come uno strumento ideale per chi desidera integrare assistenti virtuali personalizzati o localizzare contenuti multimediali senza rinunciare alla sovranità digitale.
Le ombre del progresso e le barriere delle licenze
Nonostante l’entusiasmo che circola nelle bacheche elettroniche degli sviluppatori, l’uso di questa tecnologia richiede cautela. La licenza scelta, la CC BY-NC 4.0, vieta esplicitamente l’utilizzo per scopi commerciali senza accordi preventivi con Mistral AI. Questo limite trasforma lo strumento in un potente parco giochi per la ricerca e l’uso personale, ma blocca l’integrazione immediata in prodotti destinati alla vendita.
Esiste inoltre il rischio concreto legato alla creazione di falsificazioni profonde vocali sempre più difficili da distinguere dalla realtà. Senza l’implementazione di rigide misure di marcatura digitale, il pericolo di furti d’identità o di disinformazione audio potrebbe causare una chiusura improvvisa della fiducia verso le comunicazioni digitali. Mistral AI ha comunque garantito che le versioni future integreranno protezioni più avanzate per garantire che la sintesi vocale (TTS) resti un alleato della creatività e non un’arma per i pirati informatici.
Il mio verdetto da vecchio smanettatone di schede audio
Siamo passati dal configurare gli indirizzi IRQ per far sentire due suoni MIDI a vedere macchine che parlano con la nostra stessa voce. Voxtral TTS è un pezzo di software incredibile perché restituisce il potere all’utente finale, togliendolo dalle mani dei giganti del settore. Tuttavia, la facilità con cui si può generare un doppione vocale mi mette la stessa ansia di un caricamento che si blocca al 99%: la tecnologia corre, ma la nostra capacità di gestirne le conseguenze etiche sembra rimasta ferma ai tempi del processore 386.
E voi, affidereste la vostra voce a un algoritmo per creare il vostro assistente personale ideale o temete che qualcuno possa usarla per svuotarvi il conto in banca?
Dite la vostra nei commenti e non dimenticate di scaricare gli ultimi aggiornamenti seguendo FullStackgarage.it.
Al prossimo impulso elettromagnetico! Ci vediamo tra i pacchetti della rete globale!
Il Vostro guardiano dei settori magnetici
Ciucci Gilberto