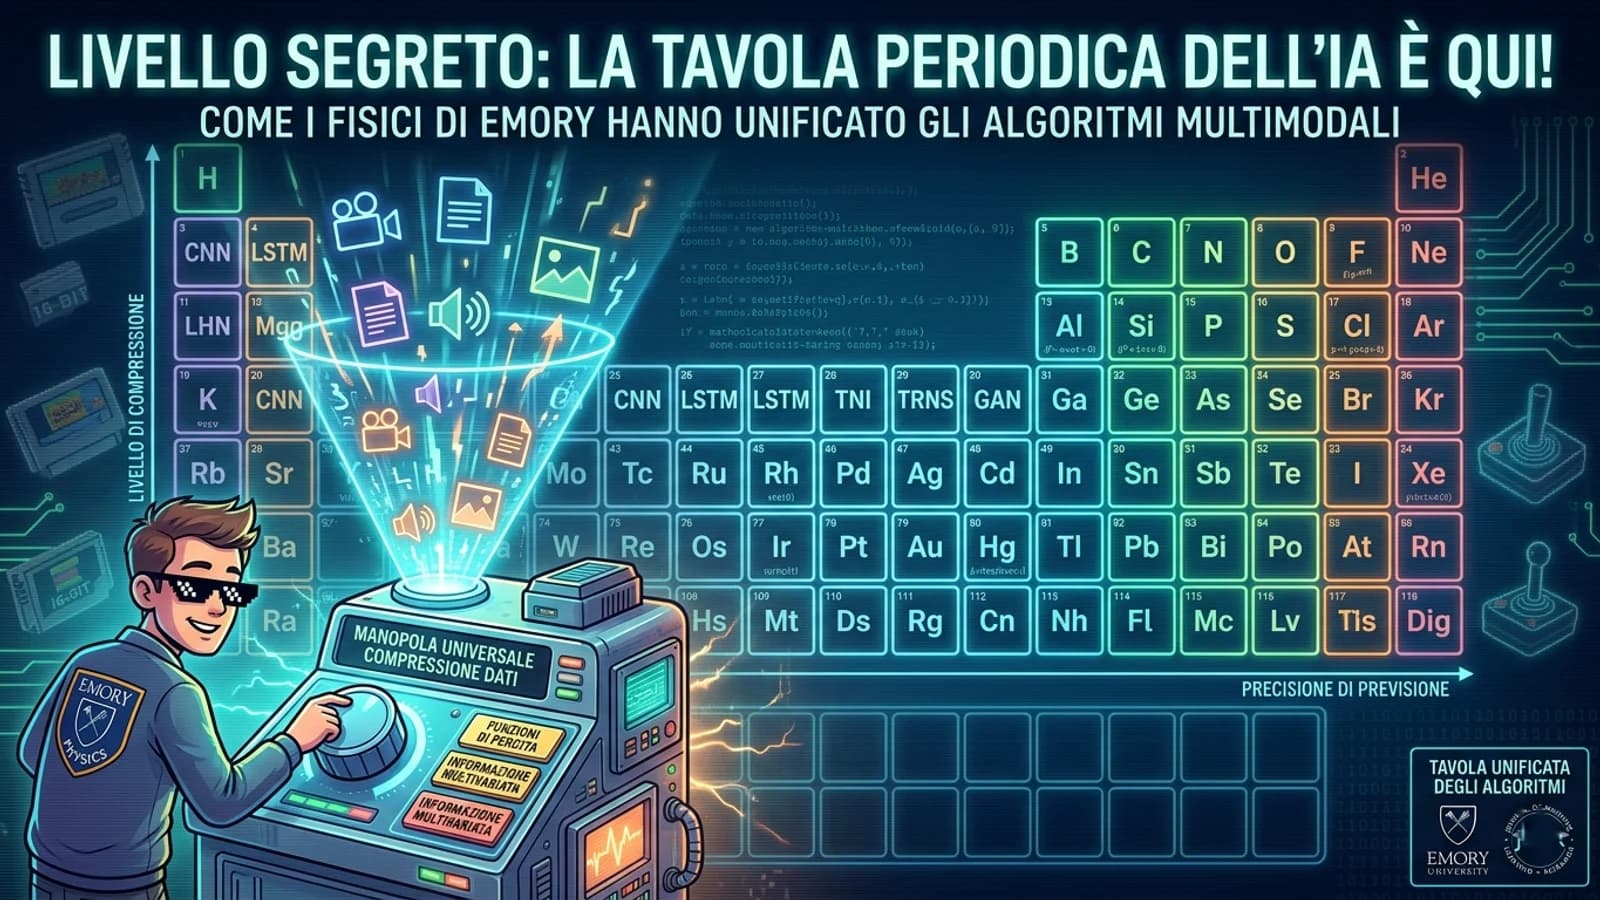
Come i fisici di Emory hanno unificato gli algoritmi multimodali in un unico schema matematico.
Nell’epoca d’oro dei processori a 16 bit sognavamo macchine capaci di capire tutto al primo colpo, ma la realtà dell’intelligenza artificiale multimediale (quella branca che mastica simultaneamente testi, immagini, audio e video) è sempre stata un caos di tentativi ed errori. Fino a oggi, scegliere l’algoritmo giusto per un problema specifico era un esercizio di pura pazienza, simile a cercare un bug in migliaia di righe di codice, senza un esperto che cerca e scova gli errori in esso. Un gruppo di fisici dell’Università Emory ha deciso di fare pulizia nel database, pubblicando sul “The Journal of Machine Learning Research” una struttura di lavoro chiamata “Variational Multivariate Information Bottleneck”. Si tratta, a tutti gli effetti, della prima tavola periodica degli algoritmi.
La manopola universale per la compressione dati
Il segreto di questo successo risiede in un’intuizione che Ilya Nemenman, professore di fisica a Emory, definisce elementare. La maggior parte dei metodi di apprendimento automatico più efficaci si basa sulla capacità di comprimere diversi tipi di informazioni conservando solo i bit necessari per fare previsioni corrette. I ricercatori hanno mappato centinaia di funzioni di perdita (ovvero le formule matematiche che dicono al sistema quanto sta sbagliando) posizionandole all’interno di una griglia sistematica.
Questa intelaiatura agisce come un pannello di controllo hardware. Michael Martini, ricercatore post dottorato, spiega che ora è possibile “girare una manopola” matematica per decidere con precisione quali dati mantenere e quali scartare. Invece di riscrivere il codice da zero per ogni nuovo progetto, gli scienziati possono ora calibrare il sistema per adattarsi a qualsiasi insieme di dati complesso, risparmiando mesi di calcoli inutili.
Meno Watt e più neuroni per il futuro
Il percorso per arrivare a questa formula non è stato un caricamento rapido. Eslam Abdelaleem, primo autore dello studio, ha passato anni a scarabocchiare lavagne prima di trovare il punto di equilibrio tra la compressione dei dati e la loro ricostruzione. La validazione del modello è stata così entusiasmante che lo smartwatch di Abdelaleem ha scambiato il suo picco di frequenza cardiaca per un faticoso allenamento di tre ore in bicicletta. Oltre all’aneddoto, i risultati sono concreti: il sistema richiede molta meno potenza computazionale rispetto ai metodi convenzionali.
Ridurre i dati necessari significa abbassare drasticamente il consumo di energia dei server, un tema che scotta più di un processore senza dissipatore. Questa efficienza apre le porte a esperimenti in settori dove i dati scarseggiano, come la biologia molecolare o le neuroscienze. L’obiettivo finale di Abdelaleem è infatti comprendere i circuiti neurali biologici, cercando analogie strutturali tra il modo in cui il nostro cervello processa gli stimoli e il funzionamento dei modelli di apprendimento automatico
Il mio verdetto da vecchio nerd che soffiava sulle cartucce
Questa scoperta è il “Game Genie” che stavamo aspettando per l’intelligenza artificiale. I fisici hanno dimostrato che sotto la complessità dei modelli moderni si nasconde una logica elegante e unificata, proprio come il codice assembly che faceva girare miracoli su hardware limitato. Avere una tavola periodica degli algoritmi significa smettere di tirare a indovinare e iniziare a costruire strumenti con la precisione di un orologio atomico. È la fine dell’era dell’alchimia digitale e l’inizio della chimica informatica vera e propria.
Riusciremo a mappare ogni singola funzione di perdita o l’IA troverà nuovi modi per sorprenderci? Scrivetelo nei commenti!
Continuate a seguire FullStackgarage.it per non perdere i prossimi pacchetti di dati sulla frontiera tecnologica.
Al prossimo aggiornamento del BIOS! Ci vediamo nel cyberspazio!
Il Vostro amministratore di sistema tra bit e realtà.
Ciucci Gilberto