Il nuovo algoritmo di Google Research che riduce l’occupazione della memoria di sei volte
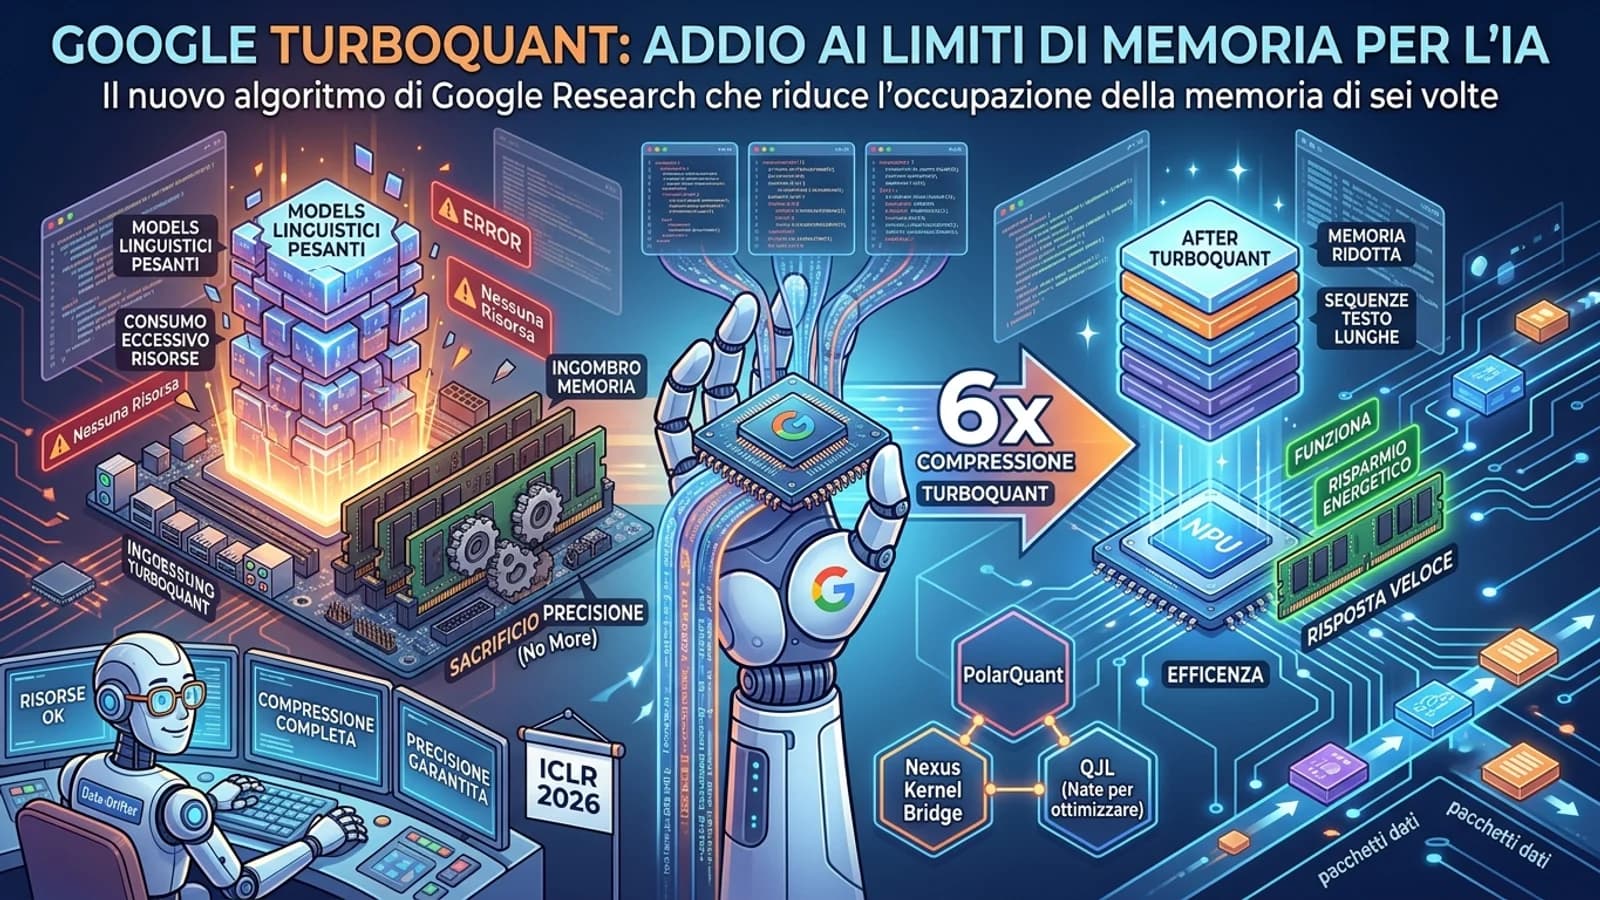
La nuova frontiera della compressione digitale ha un nome che sembra uscito da un catalogo di potenziamenti per un vecchio processore 486: TurboQuant. Questo algoritmo è stato progettato per risolvere il problema del consumo eccessivo di risorse durante l’esecuzione dei modelli linguistici più pesanti. Se la startup immaginaria Pied Piper della serie Silicon Valley cercava la compressione perfetta, Google sembra averne trovato una versione reale destinata a far discutere i frequentatori delle bacheche elettroniche (BBS) di tutto il mondo.
La tecnologia di compressione che sfida la fantasia
Il cuore del sistema risiede nella gestione della memoria tampone delle chiavi e dei valori, ovvero quella porzione di memoria di lavoro che il modello utilizza per ricordare il contesto della conversazione. TurboQuant utilizza tecniche avanzate di quantizzazione vettoriale per rimpicciolire questi dati senza sacrificare la precisione dei risultati finali.
Secondo i dati tecnici che verranno presentati ufficialmente alla conferenza ICLR 2026, l’algoritmo è in grado di ridurre l’ingombro sulla memoria di almeno sei volte rispetto ai metodi attuali. Questo significa che i sistemi potranno gestire sequenze di testo molto più lunghe utilizzando la medesima dotazione di componenti fisici. Il progetto non viaggia da solo, poiché è accompagnato da altre due soluzioni chiamate PolarQuant e QJL, nate per ottimizzare ulteriormente il peso del codice sorgente.
Il confronto con DeepSeek e il futuro del calcolo
Molti osservatori del settore hanno subito tracciato un parallelo con DeepSeek, l’azienda che ha scosso il mercato riducendo i costi di addestramento delle proprie reti neurali. Esiste però una distinzione tecnica fondamentale che va sottolineata con un pennarello indelebile. Mentre DeepSeek si concentra sul risparmio durante la fase di creazione del modello, TurboQuant interviene nella fase di utilizzo quotidiano, permettendo ai server di rispondere più velocemente con un dispendio energetico inferiore.
Nonostante l’entusiasmo che circola nei laboratori, la prudenza è d’obbligo. Per ora questa tecnologia è un prototipo funzionante in ambienti controllati e non ha ancora affrontato il test del mondo reale su larga scala. Il problema della scarsità di risorse di calcolo resta un ostacolo difficile da superare, ma TurboQuant rappresenta un passo deciso verso un’informatica meno dispendiosa d’energia e più accessibile anche per chi non possiede un centro elaborazione dati in cantina.
Il mio verdetto da vecchio appassionato di BBS
Siamo passati dal comprimere i file con l’algoritmo LZW per risparmiare pochi kilobyte sul nostro modem a 14.4k, al vedere Google che comprime i pensieri artificiali. Se TurboQuant manterrà le promesse fatte nei test di laboratorio, potremmo finalmente dire addio a quegli errori di memoria esaurita che bloccano i nostri suggerimenti preferiti. La vera rivoluzione non è solo nell’intelligenza, ma nella capacità di farla girare senza dover comprare una centrale elettrica ogni volta che apriamo una finestra di chat.
Cosa ne pensate di questo colpo di scena di Mountain View? Credete che la compressione salverà i nostri computer dal collasso dei dati?
Scrivetelo nei commenti e ricordatevi di restare sintonizzati su FullStackgarage.it per non perdere i prossimi aggiornamenti.
Preparate i vostri emulatori, ci leggiamo nel prossimo settore del disco!
Il Vostro pirata delle frequenze medie
Ciucci Gilberto